Як працює машинне навчання у реальних задачах
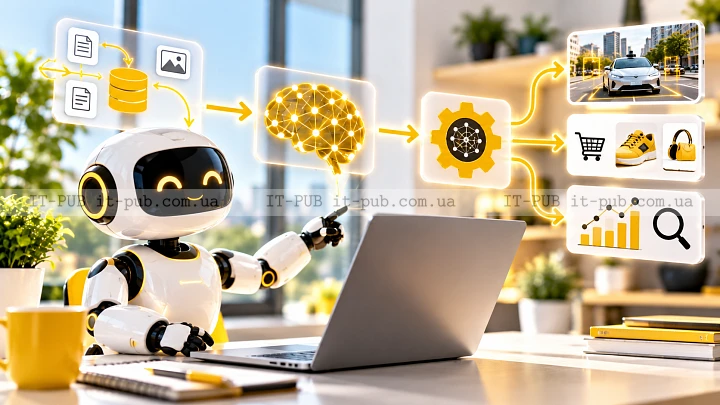
Як працює машинне навчання — питання, яке давно вийшло за межі суто IT-середовища. Ця технологія вже вбудована в безліч сервісів і продуктів, але принцип її роботи для багатьох досі виглядає чимось туманним. Якщо спростити, ідея досить проста: система вчиться знаходити закономірності в даних, а потім використовує їх, щоб робити прогнози або приймати рішення.
Що таке машинне навчання простими словами
Якщо коротко, машинне навчання — це підхід, у якому комп’ютеру не задають жорсткі правила на кожен окремий випадок. Замість цього йому дають багато прикладів, і він сам виявляє зв’язки між ними.
Тобто замість інструкції на кшталт «завжди роби ось так» система дивиться на набір даних і вчиться помічати спільні ознаки. Саме в цьому і полягає відповідь на питання, що таке машинне навчання в практичному сенсі.
Наприклад, якщо показати моделі велику кількість листів із позначками «спам» і «не спам», з часом вона почне розрізняти характерні сигнали. За тим самим принципом працюють і інші задачі: розпізнавання зображень, рекомендації контенту, прогнозування попиту чи пошук аномалій.
Важливий нюанс: машина не «розуміє» інформацію так, як це робить людина. Вона не осмислює дані, а виявляє статистичні закономірності — особливо там, де вручну було б важко обробити великі обсяги інформації.
З чого починається навчання моделі
Будь-які моделі машинного навчання починаються з даних. Без них не буде ні навчання, ні адекватного результату. Якщо дані неточні, неповні або хаотично зібрані, слабким буде і підсумок.
Модель нічого не бере «з повітря». Вона вчиться лише на тому, що їй дали.
Тому дані зазвичай готують заздалегідь: прибирають помилки, приводять до зрозумілого формату, впорядковують. Далі їх поділяють на частини. Одна потрібна для навчання, інша — щоб перевірити, як система поводиться на нових прикладах, яких раніше не бачила.
Після цього в роботу вступає алгоритм. Він робить передбачення, порівнює їх із правильними відповідями, помиляється, змінює внутрішні параметри й повторює цей цикл багато разів. Саме так модель поступово покращує результат.
Як модель вчиться знаходити закономірності
У центрі всього процесу — зменшення помилок. Модель намагається налаштувати себе так, щоб наступне передбачення було точнішим за попереднє. Це один із базових принципів машинного навчання.
Уявімо задачу, де система має відрізняти котів від собак на фото. На старті вона майже нічого не «вміє» і може видавати випадкові припущення. Але коли отримує багато прикладів із правильними мітками, починає вловлювати повторювані ознаки, характерні для кожного класу.
Це не обов’язково щось очевидне для людини. Модель може спиратися на форму вух, контури морди, текстури, співвідношення кольорів або інші дрібні деталі, які разом дають потрібний сигнал.
Тут важливо не плутати навчання із запам’ятовуванням. Модель не повинна просто зберегти всі приклади. Її цінність у тому, що вона будує узагальнення і може працювати з новими даними, а не лише з тими, які вже бачила.
Які бувають основні підходи
Машинне навчання — це не один універсальний метод, а група підходів. Вибір залежить від задачі та від того, які дані є на вході.
Найпоширеніший варіант — навчання з учителем. У цьому випадку система отримує приклади разом із правильними відповідями. Такий підхід добре підходить для класифікації або прогнозування значень — наприклад, коли потрібно визначити категорію листа, оцінити ризик чи передбачити попит.
Є й навчання без учителя. Тут готових правильних відповідей немає, тому система сама шукає структуру в даних: групує схожі об’єкти, виявляє приховані патерни або аномалії. Це корисно, коли дані не розмічені заздалегідь.
Окремий напрям — навчання з підкріпленням. У ньому модель вчиться через дії та зворотний зв’язок у вигляді винагороди. Вона пробує різні варіанти, отримує оцінку своїх рішень і поступово знаходить кращу стратегію. Такий підхід добре працює там, де важлива послідовність рішень.
Чим машинне навчання відрізняється від звичайного програмування
У традиційному програмуванні логіку зазвичай прописує людина. Якщо система має реагувати на певну умову, програміст прямо задає це правило в коді.
У машинному навчанні підхід інший: замість того щоб вручну описувати всі можливі правила, ми даємо системі дані, а вона сама виводить закономірності. Саме тому питання як працює машинне навчання часто зводиться до простої різниці: у звичайному коді правила задають наперед, у ML вони формуються під час навчання.
Це не означає, що програмування тут не потрібне. Навпаки, без нього нічого не буде: треба зібрати й підготувати дані, обрати алгоритм, налаштувати процес, перевірити результат і вбудувати модель у продукт.
Головна відмінність у тому, звідки беруться правила. У класичному підході їх пишуть вручну. У ML вони виникають на основі прикладів.
Де машинне навчання застосовують на практиці
Застосування машинного навчання давно не обмежується лабораторіями чи дослідницькими командами. Воно працює в повсякденних цифрових сервісах, навіть якщо користувач цього не помічає.
Одна з найпомітніших сфер — рекомендаційні системи. Платформи можуть радити фільми, музику, товари чи статті, орієнтуючись на поведінку користувача та схожі патерни інших людей. За цим стоїть не магія, а аналіз великої кількості сигналів.
Ще один поширений сценарій — фільтрація та класифікація. Моделі машинного навчання допомагають відсіювати спам, визначати тематику тексту, розпізнавати зображення або голос. Для бізнесу це ще й спосіб автоматизувати рутинні процеси.
Окрема велика сфера — прогнозування. На основі історичних даних система може оцінювати ймовірність подій: від навантаження на інфраструктуру до поведінки користувачів. Для технічних продуктів це особливо корисно, бо допомагає точніше планувати ресурси і швидше реагувати на зміни.
Чому якість даних важливіша, ніж здається
Коли говорять про ML, увага часто йде в бік «розумних» алгоритмів. Але на практиці все часто впирається в дані. Якщо в навчальному наборі є перекоси, модель засвоїть саме їх. Якщо даних мало, результат може бути нестабільним. Якщо вони застарілі, точність теж знизиться.
Тому підготовка даних — не технічна формальність, а одна з ключових частин усього процесу. Важливо не просто щось зібрати, а переконатися, що інформація релевантна, узгоджена і достатньо різноманітна.
Інакше навіть сильні алгоритми машинного навчання не дадуть хорошого результату.
Є й інша типова проблема: модель може добре показувати себе на тестових прикладах, але провалюватися в реальному середовищі. Зазвичай це означає, що вона занадто підлаштувалася під навчальні дані і погано узагальнює. Саме тому перевірка на нових прикладах — не опція, а необхідність.
Як зрозуміти, що модель працює добре
Оцінювати якість моделі завжди треба в контексті конкретної задачі. Для одного сценарію критичною буде загальна точність, для іншого — здатність не пропускати важливі випадки, для третього — баланс між різними типами помилок.
У задачах класифікації, наприклад, недостатньо просто знати, скільки разів модель «вгадала». Не менш важливо розуміти, де саме вона помиляється і наскільки дорогими є ці помилки в реальному сценарії.
Тому хороша модель — не та, що ідеально запам’ятала навчальний набір. Хорошою можна вважати ту, що стабільно працює на нових даних і дає корисний результат у практичному використанні.
Де машинне навчання допомагає, а де не варто на нього покладатися
Машинне навчання найкраще показує себе в задачах, де є багато прикладів і можна виявити стійкі закономірності. Особливо там, де ручні правила описати складно або де обсяг інформації занадто великий для ручної обробки.
Але сприймати його як універсальне рішення теж не варто. Якщо даних замало, якщо сама задача досить проста або якщо потрібна повна прозорість кожного рішення, іноді доцільніше обрати інший підхід. Не все має сенс автоматизувати саме через ML.
Варто пам’ятати і про межі таких систем. Вони не мають людського розуміння контексту, не спираються на здоровий глузд і можуть помилятися в неочікуваних ситуаціях. Через це в критичних сценаріях їх часто доповнюють перевірками та контролем.
Як почати розбиратися в темі без зайвої складності
Щоб зрозуміти, як працює машинне навчання, не обов’язково одразу занурюватися в складну математику. Для старту набагато корисніше побачити загальну картину: є дані, є моделі машинного навчання, є етап навчання, є перевірка і є практичне застосування.
Коли ця логіка стає зрозумілою, простіше розбиратися в деталях: що саме роблять алгоритми машинного навчання, як навчаються нейромережі, навіщо потрібна валідація і як оцінювати якість результату.
Для більшості людей цього вже достатньо, щоб скласти адекватне уявлення про тему. По суті, машинне навчання — це спосіб навчити систему робити корисні прогнози на основі попереднього досвіду, тобто даних. На цій ідеї тримається велика частина сучасних цифрових продуктів і сервісів.