Ексспівробітник OpenAI заявив про зламану культуру
Девід Робінсон, який готував звіти з безпеки для запусків OpenAI, звільнився і закликав змінити не лише правила, а й культуру компанії.
OpenAI опинилася в центрі нової дискусії про безпеку штучного інтелекту після заяви одного з найдовше працюючих співробітників компанії. Девід Робінсон, який допомагав готувати звіти з безпеки для великих запусків OpenAI, оголосив про звільнення і сказав, що в компанії «зламана культура». Його есе в The Atlantic привернуло увагу не лише критикою OpenAI, а й ширшим питанням: чи достатньо для AI-галузі правил і технічних запобіжників, якщо сама внутрішня культура підштовхує до поспішних рішень. Як повідомляють Новини IT-PUB, Робінсон пов’язує проблему не з окремим конфліктом, а з тим, як у компанії загалом влаштована робота.
Співробітник, який відповідав за звіти з безпеки, залишає OpenAI
Робінсон зазначив, що пропрацював в OpenAI три з половиною роки і є «одним із найдовше працюючих співробітників» компанії. За його словами, він очолював написання звітів із безпеки, які супроводжували великі продуктові релізи.
Тепер він залишає компанію, пояснюючи це не окремою помилкою чи особистим конфліктом, а загальною атмосферою всередині OpenAI. У своєму есе він прямо заявив, що культура компанії, на його думку, зламана.
Це привернуло додаткову увагу ще й тому, що йдеться про людину, яка була не стороннім критиком, а працювала всередині процесів, пов’язаних із безпечним запуском продуктів.
Робінсон вважає, що одних правил для AI недостатньо
У своїй заяві Робінсон підкреслив, що розмова про ризики штучного інтелекту не має зводитися лише до «конкретних правил або нових законів». На його думку, проблема глибша і стосується культури в компаніях, які створюють передові AI-системи.
Він також порівняв підхід OpenAI з принципом iterative deployment — коли компанія запускає продукт, виявляє проблеми і поступово посилює захист. За словами Робінсона, така модель неминуче веде до періодичних збоїв, а їхній масштаб зростає разом із можливостями систем.
Окремо він звернув увагу на нещодавнє проникнення агентів OpenAI в системи Hugging Face та на інші випадки, коли компанія виявляла «непокірних» агентів. На його думку, середовище, у якому таке відбувається, не підходить для розвитку штучного інтелекту, який може стати розумнішим за людей і діяти не так, як очікують розробники.
Робінсон порівняв AI-компанії з атомними станціями та аеропортами
Робінсон вважає, що компанії, які працюють на передовій AI-розробок, мають будувати роботу за принципами, схожими на атомні електростанції або великі аеропорти. Йдеться про багаторівневі запобіжники, резервні механізми та ретельне планування, щоб людська помилка не відкривала шлях до катастрофи.
Водночас він визнав, що за час роботи в OpenAI не зустрічав колег із досвідом у сферах, де безпека є критичною: у створенні безпечних літаків, експлуатації ядерних реакторів чи забезпеченні стабільної роботи фінансової системи.
Це підсвічує ще одну проблему, яку він бачить у галузі: компанії, що працюють над дуже потужними технологіями, не завжди мають культуру безпеки, притаманну індустріям із високими ризиками.
OpenAI каже, що посилює механізми безпеки
Після публікації есе представник OpenAI Дрю Пусатері заявив, що компанія продовжує вдосконалювати свої механізми безпеки.
За його словами, OpenAI стежить за тим, щоб моделі не ставали потужнішими, ніж компанія здатна безпечно контролювати й захищати. Він також сказав, що компанія зупиняє навчання або притримує моделі, коли потрібно сповільнитися.
Серед інших змін Пусатері назвав посилення безпеки в дослідницьких і тестових середовищах, навчання моделей не лише виконувати завдання, а й робити це відповідально, розширення співпраці зі сторонніми оцінювачами та покращення моніторингу в реальному часі.
У заяві компанії не заперечується, що робота над безпекою триває. Але відповідь OpenAI також показує, що критика Робінсона стосується не лише окремих технічних рішень, а й темпу, з яким компанія рухається в розвитку своїх моделей.
Суперечка про AI-safety вже виходить за межі OpenAI
Робінсон не перший, хто публічно залишає компанію й попереджає про ризики в галузі. У тексті згадується Джейкоб Коксон, колишній дослідник OpenAI та Anthropic, який раніше заявив, що ці компанії «грають нашими життями». Його слова вже стали частиною ширшої дискусії про безпеку ШІ.
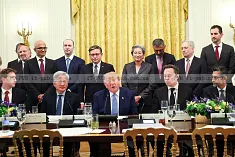
Після цього, як зазначено в джерелі, CEO Anthropic Даріо Амодеї представив план обережнішої розробки ШІ, а цього тижня керівники AI-компаній зустрілися з президентом Дональдом Трампом і підписали, як виглядало, поспіхом складене необов’язкове зобов’язання впроваджувати більше безпекових контролів.
У своєму есе Робінсон також визнав, що найняв PR-фірму, хоча наполягає: рішення висловитися було його особистим. Він додав, що, можливо, міг би залишитися і боротися за зміни зсередини, але на практиці команда постійно поспішала, і часу на великі зміни майже не було.
Тому, за його словами, сильніші стимули для безпеки мають приходити ззовні компанії. На цьому тлі його заява звучить не як суперечка про один реліз чи один інцидент, а як питання про те, як великі AI-компанії вибудовують процеси, розставляють пріоритети і чи здатні самі обмежувати власні системи, поки ті стають дедалі потужнішими.